> For the complete documentation index, see [llms.txt](https://developers.oxylabs.io/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://developers.oxylabs.io/products/es/web-scraper-api/features/result-processing-and-storage/cloud-storage.md).

# Cloud Storage

Recupera tus resultados extraídos directamente en tu almacenamiento S3, GCS, OSS u otro compatible con S3.

Los resultados de los trabajos de Scraper API se almacenan en nuestro almacenamiento. Puede obtener sus resultados de nuestro almacenamiento haciendo `GET` al `/results` endpoint.

Como alternativa, podemos cargar los resultados en su almacenamiento en la nube. De este modo, no tiene que hacer solicitudes adicionales para obtener los resultados: todo va directamente a su bucket de almacenamiento.

{% hint style="info" %}
La integración con almacenamiento en la nube solo funciona con [**Push-Pull**](https://developers.oxylabs.io/products/es/web-scraper-api/integration-methods/push-pull.md) método de integración.
{% endhint %}

Actualmente, admitimos estos servicios de almacenamiento en la nube:

* [**Google Cloud Storage**](#google-cloud-storage)
* [**Amazon S3**](#amazon-s3)
* [**Alibaba Cloud Object Storage Service (OSS)**](#alibaba-cloud-object-storage-service-oss)
* [**BytePlus Torch Object Storage (TOS)**](#byteplus-tos)
* [**Otro almacenamiento compatible con S3**](#other-s3-compatible-storage)

Si desea usar otro tipo de almacenamiento, póngase en contacto con su gerente de cuenta para hablar sobre el plazo de entrega de la función.

La ruta de carga es así: `YOUR_BUCKET_NAME/job_ID.json`. Encontrará el ID del trabajo en la respuesta que recibe de nosotros después de enviar un trabajo.

#### Entrada

<table><thead><tr><th>Parámetro</th><th width="187.33333333333331">Descripción</th><th>Valores válidos</th></tr></thead><tbody><tr><td><code>storage_type</code></td><td>Su tipo de almacenamiento en la nube.</td><td><p><code>gcs</code> (Google Cloud Storage);</p><p><code>s3</code> (AWS S3); <code>tos</code> (BytePlus TOS);</p><p><code>s3_compatible</code> (cualquier almacenamiento compatible con S3).</p></td></tr><tr><td><code>storage_url</code></td><td>Nombre / URL de su bucket de almacenamiento en la nube.</td><td><ul><li>Cualquiera <code>s3</code> , <code>gcs</code> , o <code>tos</code> nombre del bucket;</li><li>Cualquiera <code>compatible con S3</code> URL de almacenamiento.</li></ul></td></tr></tbody></table>

## **Google Cloud Storage**

El siguiente payload hará que Web Scraper API haga scraping de `https://example.com` y coloque el resultado en un bucket de Google Cloud Storage.

```json
{
    "source": "universal",
    "url": "https://example.com",
    "storage_type": "gcs",
    "storage_url": "bucket_name/path"
}
```

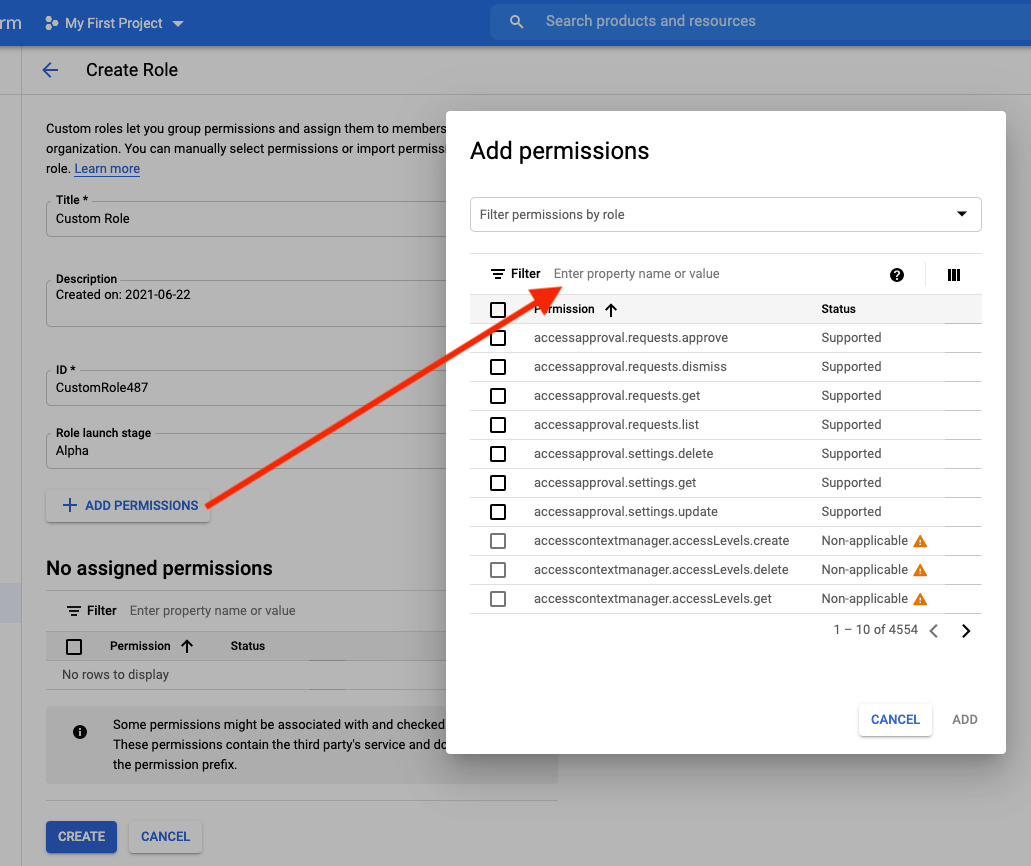
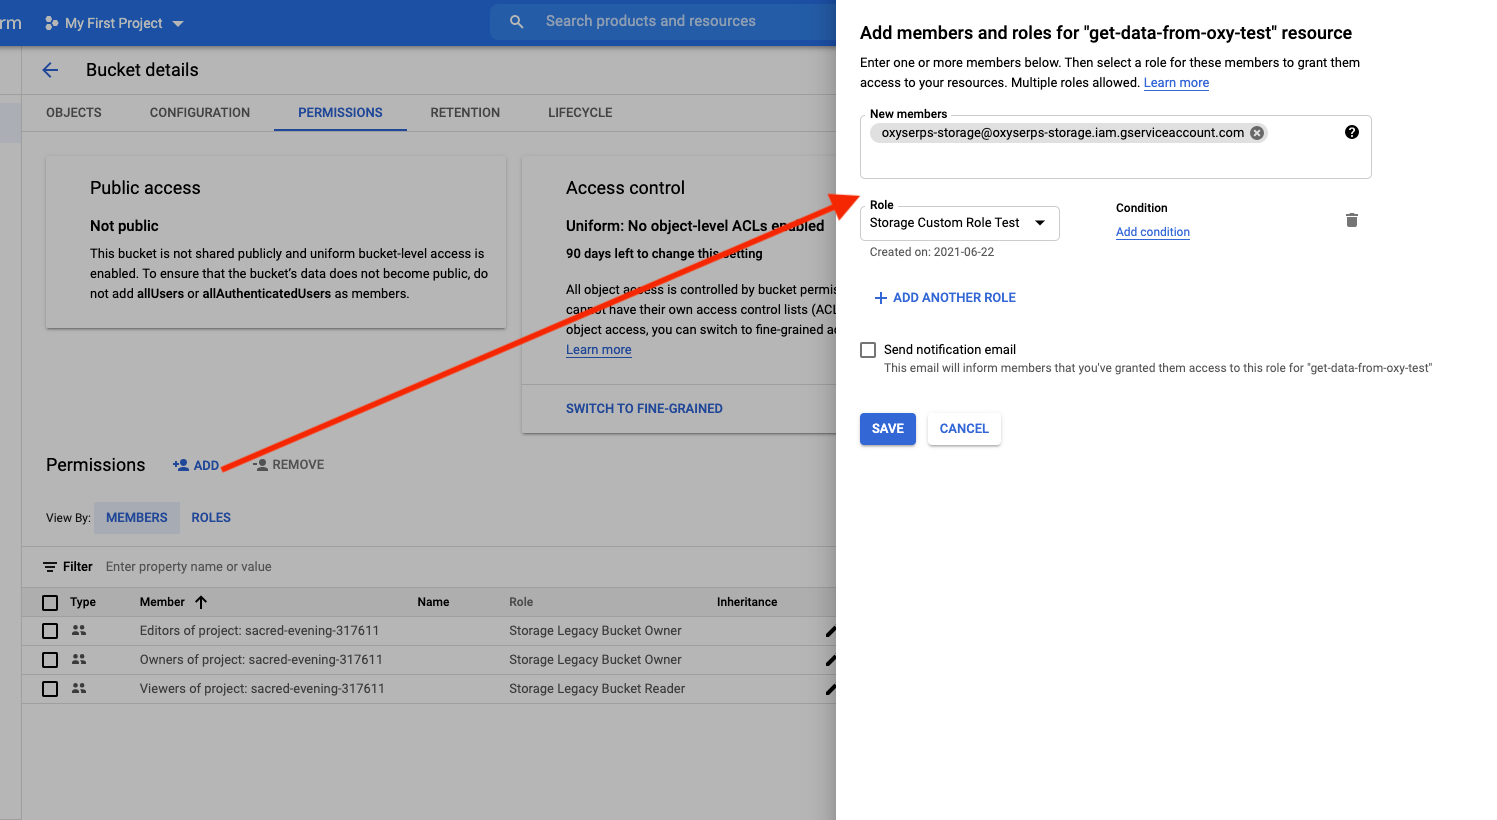
Para que los resultados de su trabajo se carguen en su bucket de Google Cloud Storage, configure permisos especiales para nuestro servicio como se muestra abajo:

{% stepper %}
{% step %}
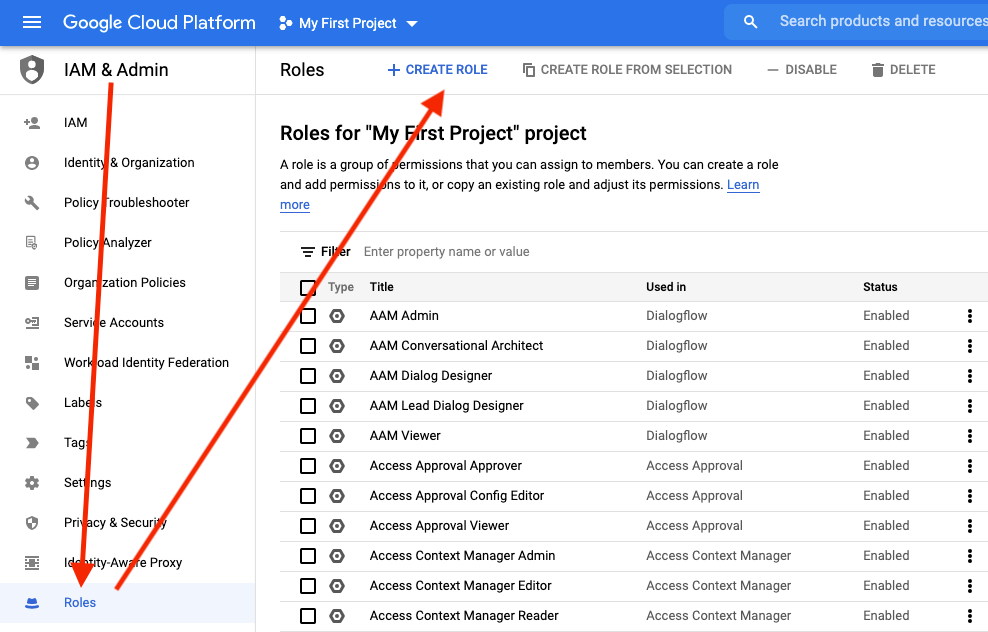
**Cree un rol personalizado**

<div align="left"><img src="https://2786356907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FBQ7Zf9paoN3FTeGcyfY1%2Fuploads%2Fgit-blob-32292235b253d2435d5e0a8d88558c068872956d%2Fgcs-1.png?alt=media" alt=""></div>
{% endstep %}

{% step %}
**Añada `storage.objects.create` permiso**

<div align="left"><img src="https://2786356907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FBQ7Zf9paoN3FTeGcyfY1%2Fuploads%2Fgit-blob-815bad910c08ed706d3df43ddb20fff0f0563d6d%2Fgcs-2.png?alt=media" alt=""></div>
{% endstep %}

{% step %}
**Asígnelo a Oxylabs**

En el **Nuevos miembros** campo, introduzca lo siguiente **correo electrónico de la cuenta de servicio de Oxylabs**:

```
oxyserps-storage@oxyserps-storage.iam.gserviceaccount.com
```

<div align="left"><img src="https://2786356907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FBQ7Zf9paoN3FTeGcyfY1%2Fuploads%2Fgit-blob-df5b74908cc6943c8d620b5e14487f2d003ebe43%2Fgcs-3.png?alt=media" alt=""></div>
{% endstep %}
{% endstepper %}

## **Amazon S3**

El siguiente payload hará que Web Scraper API haga scraping de `https://example.com` y coloque el resultado en un bucket de Amazon S3.

```json
{
    "source": "universal",
    "url": "https://example.com",
    "storage_type": "s3",
    "storage_url": "bucket_name/path"
}
```

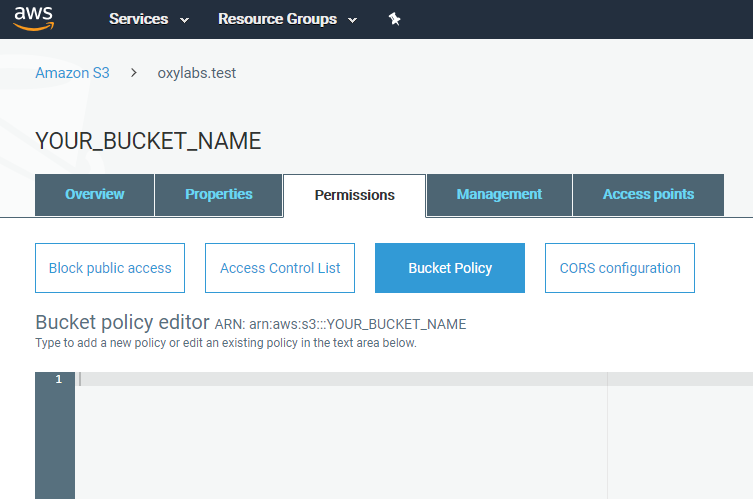
Para que los resultados de su trabajo se carguen en su bucket de Amazon S3, configure permisos de acceso para nuestro servicio. Para ello, vaya a [**https://s3.console.aws.amazon.com/**](https://s3.console.aws.amazon.com/) → **`S3`** → **`Almacenamiento`** → **`Nombre del bucket`**` `` ``(if you don't have one, create a new one) ` → **`Permisos`** → **`Política del bucket`**.

<div align="left"><img src="https://2786356907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FBQ7Zf9paoN3FTeGcyfY1%2Fuploads%2Fgit-blob-1c27676a6e925e4a8c257cf422e991c8a6a1af2c%2Fs3_bucket_policy.png?alt=media" alt=""></div>

Puede encontrar la política del bucket adjunta abajo o en el área de ejemplo de código.

{% file src="/files/e069034d243398f8dc01f795c1600a61c351f20f" %}
política del bucket S3
{% endfile %}

No olvide cambiar el nombre del bucket en `YOUR_BUCKET_NAME`. Esta política nos permite escribir en su bucket, darle acceso a los archivos cargados y conocer la ubicación del bucket.

```json
{
    "Version": "2012-10-17",
    "Id": "Policy1577442634787",
    "Statement": [
        {
            "Sid": "Stmt1577442633719",
            "Effect": "Allow",
            "Principal": {
                "AWS": "arn:aws:iam::324311890426:user/oxylabs.s3.uploader"
            },
            "Action": "s3:GetBucketLocation",
            "Resource": "arn:aws:s3:::YOUR_BUCKET_NAME"
        },
        {
            "Sid": "Stmt1577442633719",
            "Effect": "Allow",
            "Principal": {
                "AWS": "arn:aws:iam::324311890426:user/oxylabs.s3.uploader"
            },
            "Action": [
                "s3:PutObject",
                "s3:PutObjectAcl"
            ],
            "Resource": "arn:aws:s3:::YOUR_BUCKET_NAME/*"
        }
    ]
}
```

## Alibaba Cloud Object Storage Service (OSS)

El siguiente payload hará que Web Scraper API haga scraping de `https://example.com` y coloque el resultado en un bucket de Alibaba Cloud OSS.

```json
{
    "source": "universal",
    "url": "https://example.com",
    "storage_type": "s3_compatible",
    "storage_url": "https://ACCESS_KEY_ID:ACCESS_KEY_SECRET@BUCKET_NAME.oss-REGION.aliyuncs.com/FOLDER_NAME"
}
```

### Cómo formar la URL de almacenamiento <a href="#forming-the-storage-url" id="forming-the-storage-url"></a>

Formato de la URL de almacenamiento:

```http
https://ACCESS_KEY_ID:ACCESS_KEY_SECRET@BUCKET_NAME.oss-REGION.aliyuncs.com/FOLDER_NAME
```

{% hint style="warning" %}
Actualmente, **no podemos cargar al bucket raíz**. Proporcione un nombre de carpeta específico para sus cargas.
{% endhint %}

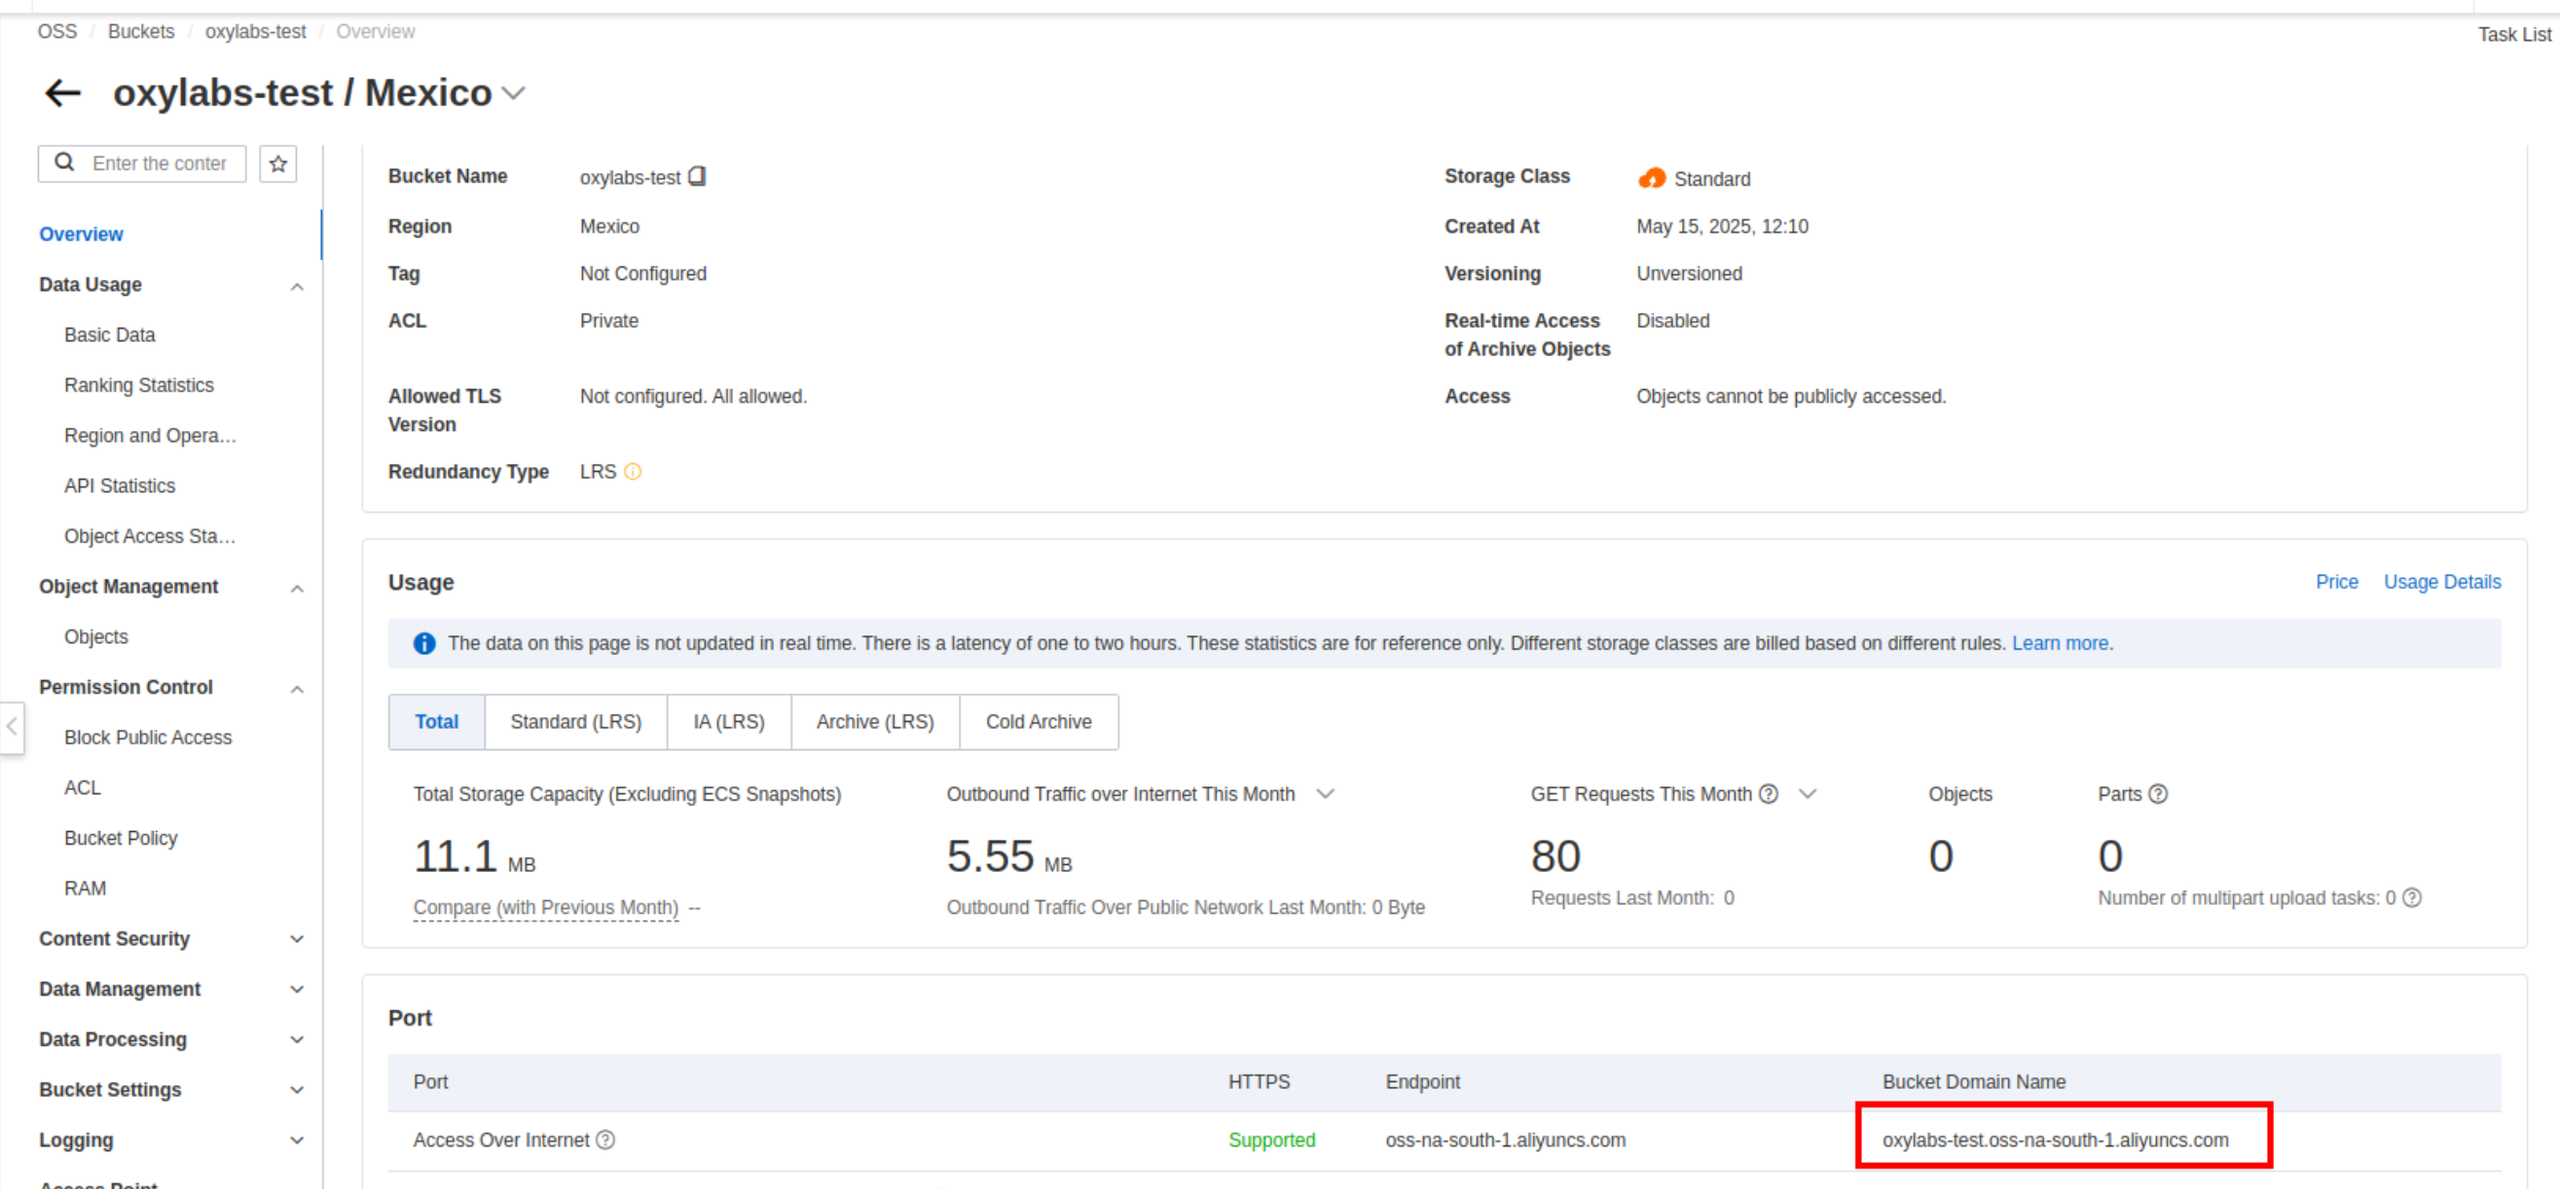
Aquí encontrará el `BUCKET_NAME` y `oss-REGION` de su bucket:

<figure><img src="https://2786356907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FBQ7Zf9paoN3FTeGcyfY1%2Fuploads%2Fgit-blob-3258197766d6326f572b9230603b3f700738db36%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

### Cómo crear la clave de acceso y el secreto <a href="#creating-the-access-key-and-secret" id="creating-the-access-key-and-secret"></a>

Para usar la interfaz compatible con S3 con Alibaba OSS, debe crear `ACCESS_KEY_ID` y `ACCESS_KEY_SECRET` como se muestra abajo. Para más información, consulte [![](https://img.alicdn.com/tfs/TB1ugg7M9zqK1RjSZPxXXc4tVXa-32-32.png)Cómo usar los SDK de Amazon S3 para acceder a OSS](https://www.alibabacloud.com/help/en/oss/developer-reference/use-amazon-s3-sdks-to-access-oss?spm=a2c63.p38356.0.i1).

{% stepper %}
{% step %}
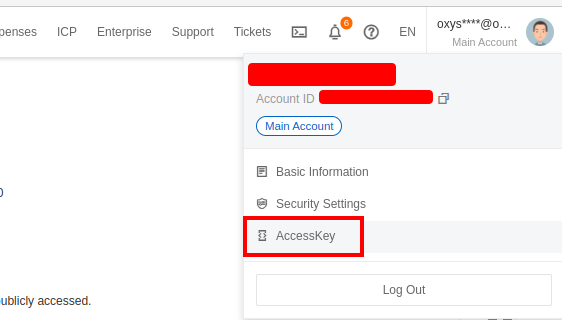
Vaya al **menú de cuenta de AccessKey**

<div align="left"><figure><img src="https://2786356907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FBQ7Zf9paoN3FTeGcyfY1%2Fuploads%2Fgit-blob-7a0c00eac6fd02fed28c7be5a5522985de3625d5%2Fimage.png?alt=media" alt="" width="422"><figcaption></figcaption></figure></div>
{% endstep %}

{% step %}
Inicie sesión en la **RAM console**

Acceda a la [RAM console](https://ram.console.aliyun.com/) usando una **Alibaba Cloud** o un **RAM User** que tenga permisos administrativos.
{% endstep %}

{% step %}
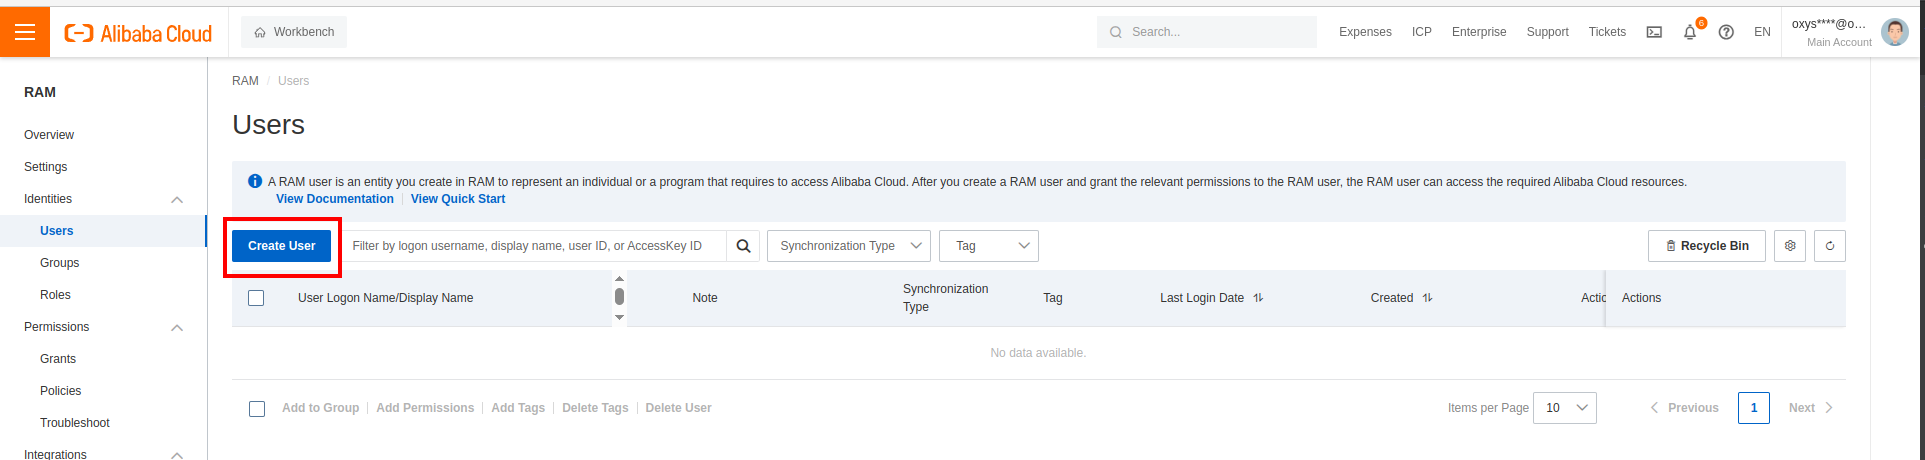
Vaya a **Identidades** → **Usuarios** en el panel de navegación izquierdo
{% endstep %}

{% step %}
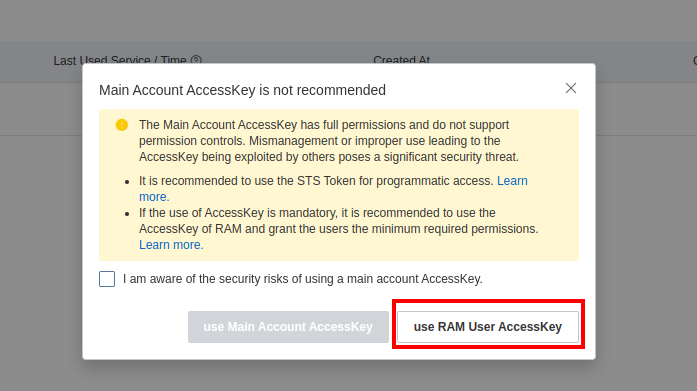
Seleccione **Crear usuario** y use la **RAM User AccessKey:**

<div align="left"><figure><img src="https://2786356907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FBQ7Zf9paoN3FTeGcyfY1%2Fuploads%2Fgit-blob-e06b15f92c10028d2f5c368321821a90abf01f3f%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure></div>

<div align="left"><figure><img src="https://2786356907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FBQ7Zf9paoN3FTeGcyfY1%2Fuploads%2Fgit-blob-4103046af7ce401cd189cd53f238fddf41b64ab5%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure></div>
{% endstep %}

{% step %}
**Conceda permisos al RAM User**

El RAM User recién creado no tiene permisos. Debe otorgar **AliyunOSSFullAccess** permisos al RAM User. Entonces, el RAM User podrá acceder a los recursos necesarios de Alibaba Cloud. Para más información, consulte [Conceder permisos a los usuarios RAM](https://www.alibabacloud.com/help/en/ram/user-guide/grant-permissions-to-the-ram-user#task-187800).

<div align="left"><figure><img src="https://2786356907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FBQ7Zf9paoN3FTeGcyfY1%2Fuploads%2Fgit-blob-6d76a9af42bd9f8eaabdbee6c4baadd5824a0a09%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure></div>
{% endstep %}

{% step %}
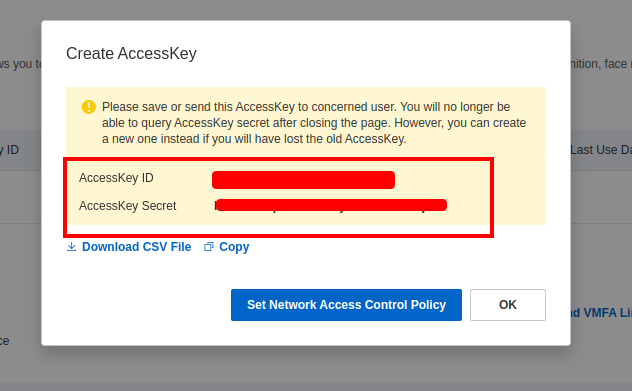
Obtenga su **AccessKey ID** y **AccessKey Secret**

Cuando se hayan concedido los permisos, vuelva a la **Autenticación** sección y, en la **clave de acceso** sección, seleccione **Crear AccessKey**. Elija crear una clave de acceso para un **servicio de terceros**. Entonces verá una clave, `ACCESS_KEY_ID` y `ACCESS_KEY_SECRET`que luego podrá usar en sus solicitudes.
{% endstep %}
{% endstepper %}

### Límites de tasa de Alibaba OSS <a href="#alibaba-oss-ratelimits" id="alibaba-oss-ratelimits"></a>

Al realizar cargas simultáneas en Alibaba OSS, es posible alcanzar los límites de tasa de la cuenta/del bucket, y las cargas empezarán a agotar el tiempo con el siguiente error:

<div align="left"><figure><img src="https://2786356907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FBQ7Zf9paoN3FTeGcyfY1%2Fuploads%2Fgit-blob-8c6734c7968642444e43843fb1f200f0ab739c81%2Fimage.png?alt=media" alt="" width="563"><figcaption></figcaption></figure></div>

En ese caso, póngase en contacto con el soporte de Alibaba OSS para aumentar sus límites de tasa de OSS.

## BytePlus TOS

Puede cargar los resultados extraídos directamente a un bucket de BytePlus Torch Object Storage (TOS).

Para una conexión correcta, necesitará:

* Un bucket TOS configurado correctamente.
* Su clave de acceso y clave secreta.
* Un endpoint compatible con S3.

Puede encontrar una lista de todos los endpoints S3 disponibles en la documentación oficial de BytePlus [documentación](https://docs.byteplus.com/en/docs/tos/docs-region-and-endpoint).

### Ejemplo

El siguiente payload hará scraping de `https://example.com` y cargará los resultados en su bucket TOS.

```json
{
    "source": "universal",
    "url": "https://example.com",
    "storage_type": "tos",
    "storage_url": "https://access_key:secret_key@endpoint/bucket_name/path"
}
```

### Parámetros <a href="#docs-internal-guid-dbfc45c7-7fff-9754-b71a-bacb24e2ac54" id="docs-internal-guid-dbfc45c7-7fff-9754-b71a-bacb24e2ac54"></a>

<table><thead><tr><th width="166">Parámetro</th><th width="165">Valores disponibles</th><th>Descripción</th></tr></thead><tbody><tr><td><code>storage_type</code></td><td><code>tos</code></td><td>Especifica BytePlus TOS como proveedor de almacenamiento.</td></tr><tr><td><code>storage_url</code></td><td>cadena URL</td><td>URL autenticada a su bucket TOS (consulte el formato abajo).</td></tr></tbody></table>

### Formato de la URL de almacenamiento

La URL de almacenamiento `storage_url` debe construirse usando sus credenciales TOS y los detalles del bucket.

```bash
https://access_key:secret_key@endpoint/bucket_name/path
```

| Componente    | Descripción                                                                     |
| ------------- | ------------------------------------------------------------------------------- |
| `access_key`  | Su ID de clave de acceso de BytePlus.                                           |
| `secret_key`  | Su clave de acceso secreta de BytePlus.                                         |
| `endpoint`    | El endpoint específico de la región (p. ej., `tos-cn-hongkong.bytepluses.com`). |
| `bucket_name` | Nombre del bucket de destino.                                                   |
| `path`        | *(Opcional)* Ruta específica de la carpeta del bucket.                          |

{% hint style="warning" %}
Si su Access Key o Secret Key contiene caracteres especiales (como `/`, `+`, o `=`), estos **deben codificarse en URL** antes de construir la cadena.
{% endhint %}

### Nomenclatura de archivos de salida

Oxylabs genera automáticamente nombres de archivo para los objetos cargados según los detalles del trabajo:

* **HTML/Contenido:** `{query_id}_{timestamp}.html`
* **Datos analizados:** `{query_id}_results.json`

Los archivos estarán accesibles en su bucket en: `tos://{bucket_name}/{path}/{filename}`

## Otro almacenamiento compatible con S3

Si desea recibir sus resultados en una ubicación de almacenamiento compatible con S3, deberá incluir la `ACCESS_KEY:SECRET` cadena de autenticación en el `storage_url` valor del payload:

```json
{
    "source": "universal",
    "url": "https://example.com",
    "storage_type": "s3_compatible",
    "storage_url": "https://ACCESS_KEY:SECRET@s3.oxylabs.io/my-videos"
}
```


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://developers.oxylabs.io/products/es/web-scraper-api/features/result-processing-and-storage/cloud-storage.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.